
从 Ampere 的 mma.sync、Hopper 的 wgmma 到 Blackwell 的 tcgen05,梳理 Tensor Core 的 Fragment 布局、数据供给和异步执行。
从最普通的 GEMM 开始,一个矩阵乘法 可以写成
最直接的实现是在 维上循环,每次读一个 ,一个 ,做一次乘加。如果完全不做数据复用,一个 FP32 FMA:
需要读 ,再写回 。其中的计算量仅有 2 FLOP,而数据的访问量为 ,因此计算强度仅有
即便是稍微复用了 accmulator 的 naive FP32 GEMM,其计算强度也仅有 ,受到带宽的约束只能跑到 fp32 峰值的 2.6%。
其瓶颈主要是数据供给,每个元素只用一次就丢弃,没有进行任何复用。矩阵乘法优化中的一个很朴素的想法就是,一份数据既然已经搬运了,就尽量多计算几次。而矩阵乘法就很适合,对于一个 的 GEMM,计算量为 ,而需要处理的数据量仅有 ,当 Tile 越大, 同一块数据被重复利用的次数就越多,效率也就越高。Tensor Core 就是一个专门执行小块矩阵乘加的硬件单元,其中的 的形状和支持的数据类型受到硬件规定,其通常一次处理一个固定形状的 Tile。这样做还有一个好处,如果做成一个完全独立的“大矩阵乘设备”,矩阵乘法开始之后,中间很难插入别的工作。现在的设计仍然保留 CUDA Core、Shared Memory、Register 等原有体系,程序员只需要负责组织数据和 Pipeline,Tensor Core 只负责其中计算密度最高的矩阵乘加。要进行 Tensor Core 的调用,需要了解 指令的相关信息:
根据这条指令提供的信息,可以进一步计算其计算强度:
可以看到,mma 的计算强度是 ffma 计算强度的 26 倍。
按照计算的过程,提高 MNK 也能进一步提高计算强度,但是数据输入的压力也随之增大,且 tile 需要存放空间,这也是后续几代硬件改动的直接动因。
计算一下 A100 的 Tensor Core 峰值:
一条 m16n8k16 的指令的计算强度为 4096 FLOP,HMMA 的延迟为 8 cycles:
每个 SM 有 4 个 subpartition:
108 个 SM:
再乘上 1.41 GHz:
这与 A100 的约 312 TFLOPS FP16 Tensor Core 峰值相对应。但是问题也随之出现:A100 的机器平衡点约为:
而一条 MMA 仅有 3.2 FLOP/Byte,相差近 50 倍。因此真正的 GEMM Kernel 不能执行一次 MMA 就重新去 Global Memory 搬数据,而是要继续分块、复用,并且在不同内存层次之间建立 Pipeline。
元素总数 D/A/B/C=128/256/128/128,由一个 warp 的 32 个线程分摊,一个寄存器 32 bit,fp16 两个打包在一个寄存器,fp64 占两个。Tensor Core 的核心问题就是,如何为计算准备数据。
这张图展示的是 mma.m16n8k16 中 A 矩阵的 fragment 在线程之间的分布方式。一个 的 A 矩阵中共有 256 个 FP16 元素,由一个 warp 的 32 个线程共同持有,因此平均每个线程负责 8 个元素。以 T0 为例,它持有 这 8 个元素,分别记作 。其余线程按照固定规则分担剩余位置,最终 32 个线程合起来组成完整的 A 矩阵 fragment,并协同执行一次 warp 级 MMA 运算。
如果完全手写,可以根据 lane_id 推导每个 Thread 应该 Load 哪几个元素。例如 A Fragment 中会有类似:
再根据寄存器的编号计算:
然后每个 Thread 自己从 Shared Memory 中将对应元素 load 到寄存器,这样可以写但是很容易出错,矩阵的形状一遍,Fragment Layout 也可能随之变化;A、B、D 的映射又不完全相同。于是 Ampere 中提供了一个 ldmatrix 指令来专门搬运矩阵数据。
ldmatrix 调用方式ldmatrix 按照 Tensor Core 规定的 Fragment Layout 从 Shared Memory 将一个小矩阵自动分发到 Warp 的寄存器中。这样就不需要程序员手动计算每个 lane 应该去读取哪个地址。例如 ldmatix.x4 会让 Warp 一次处理四个小矩阵,最终将数据放到各线程对应的寄存器。传给 ldmatrix 的是每个小矩阵的起始地址,硬件拿到起始地址后,再按照 Fragment Layout 自动完成 Scatter。
并且,四个小矩阵按什么顺序填写,就按照什么次序回到 {%0, %1, %2, %3},填对了就是正确的 fragment,不用再进行移动。
ldmatrix 无法消除 Bank Conflictldmatrix 能够自动排 Fragment,并不意味着它能自动解决 Shared Memory 的 Bank Conflict。Shared Memory 有 32 个 banks,每个 bank 宽 4 Byte,而 ldmatrix 经常以 16 B 为单位处理数据。一次 ldmatrix.x4 读取 ,如果 Shared Memory 每 cycle 可以提供 128 B,理论下限就是 ,如果地址布局不好,多组 Lane 访问到相同的 Bank,就会出现额外的串行化。因此需要另外处理 Layout,swizzle 就是一个非常好的手段,其目标是重新排列矩阵在 Shared Memory 中的地址,让同一批并行访存尽量落到不同的 Bank 上。
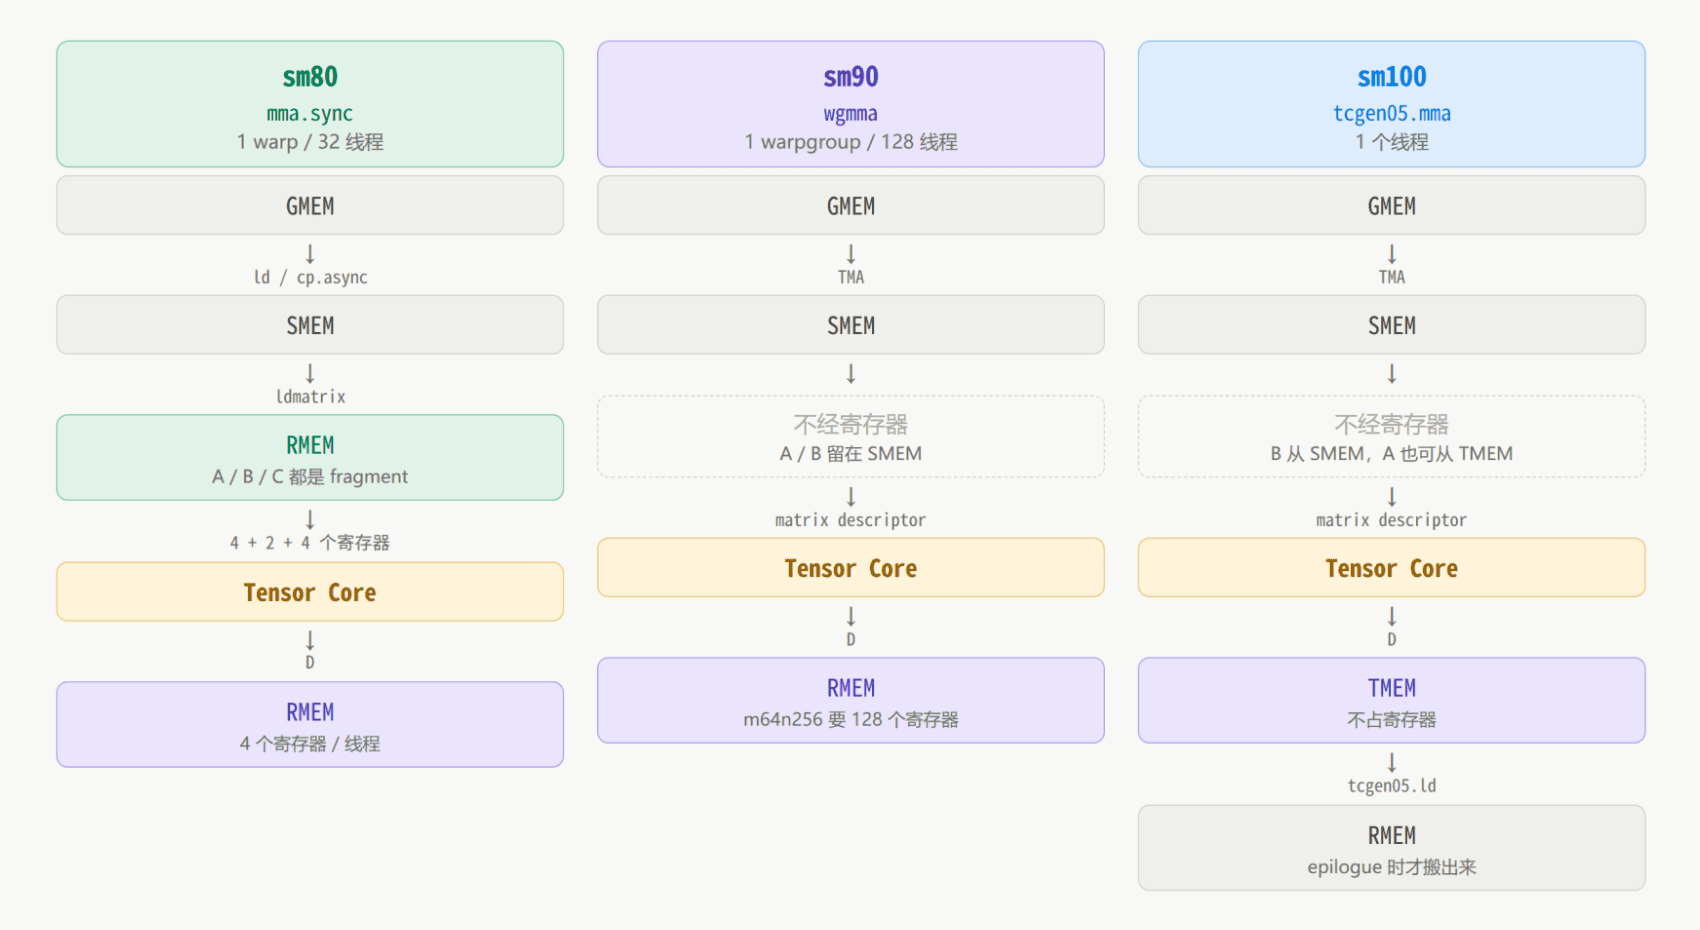
至此,sm 80 的数据准备阶段基本如下:GMEM -> SMEM -> ldmatrix -> Register Fragment -> mma.sync -> Register Accumulator
到了 sm 90,Tensor Core 的算力继续增加, mma.sync 此时开始遇到一个很实际的问题:Register Bandwidth。sm 80 中的 A,B,C,D 均需要经过寄存器,一条 MMA 如果平均分摊到 8 cycle,大约需要读 160 B/cycle,写 64 B/cycle,Tensor Core 性能再翻倍,就意味着寄存器带宽也要跟着翻倍。但是 Register File 本身就是很昂贵的硬件资源,不可能每代 GPU 都按照 Tensor Core 的速度无限堆积下去。
因此 sm 90 主要进行了三个改动:
一条 wgmma 指令驱动整个 SM 的 4 组 Tensor Core:
其中 wgmma 表示 4 个 warp 组成一个 warpgroup,一条指令调动整个 SM 的 4 组 Tensor Core,tile 为 。aligned 意味着 128 个线程必须全部执行,发散是未定义行为,mma_async 则指示指令发射完后需立即返回。
在 sm90 中,一个 SM 等于 4 个子分区,有 4 组 tensor core,4 个 warp 组成一个 warpgroup,一条指令直接调动整个 SM。m64n64k16 中,4 warp 每个依然是 16 行,因此 M=64,K 则由数据类型决定,长度恒为 32 B(fp16/bf 16→16, tf32→8,fp8/int8→32,b1→256),N 则从 8 起,步长为 8,最大为 256。
与 sm80 的 mma 不同的是,wgmma 不再有 .row.col,主序信息移入 descriptor 与末尾的两个 trans 字段。A 可以是 K-major 或 M-major,B 可以 K-major 或 N-major。
此外,.a_desc/b_desc ,A/B 不再是寄存器 fragment,而是 Shared memory Descriptor,可以将其理解为 Tensor Core 能够直接理解的一份 Shared Memory 排布描述,Hopper 会将数组组织成一种固定的 Canonical Layout,基础单位是 8 rows x 16 Byte 的 Core Matrix,这里用 16 Byte 作为单位,而不是固定的元素,因此在数据类型变化后,Layout 的基本结构仍旧可以继续使用,一个大的 Tile 就是由很多 Core Matrix 组成,要描述这些小块在 Shared Memory 中如何移动,主要需要两个步长:
再加上:
一起编码进 64-bit Descriptor。这就解决了数据的位置和排布的问题,但是无法解决 Shared Memory Bank Conflict。一个 Core Matrix 每行是 16 Byte,刚好覆盖 4 个 4 B 的 Bank,因此可以将 4 个连续的 Bank 看成是一个 bank group,32 个 Bank 一共有 32/4=8 个 Bank Group。如果每行间距正好是 128 B,即 32 个 Bank,下一行又会落回相同的 Bank,于是 Core Matrix 的 8 行可能全部都撞在同一组 Bank 上。
解决方案就是采用 Swizzle,一个较为直观的方法就是将 bank-group bits 和 row bits 做 XOR,于是不同 Row 被重新映射到不同的 Bank Group:
这样矩阵的逻辑内容没有变化,只是 Shared Memory 中的实际地址被重新排列。
前面提到 mma_async 则指示指令发射完后需立即返回,也就是说指令是异步的,这样又多了一个内存可见性的问题,Hopper 中可以粗劣区分:
两边即使访问的是同一块 Shared Memory,也不能默认对方立即看见自己的写入。例如 CUDA Core:st.shared A,然后马上让 WGMMA 使用 A,并不能只靠程序顺序保证数据可见,需要使用 fence.proxy.async.shared::cta 来建立 Generic→Async 的可见性。
在有了 Async WGMMA 后,计算过程可以并行进行:
还可以让不同的 warpgroup 来进行分工:一部分作为 producer 对数据进行 TMA/load,而 consumer warpgroup 则通过 wgmma 来对数据进行处理。
wgmma 还有一些限制:必须使用 -arch=sm_90a,缺少末尾的 a 会导致找不到 wgmma,且该指令不向前兼容,Blackwell 不支持 wgmma,且 D 仍然留在寄存器中,m64n256 每线程需要 128 个 f32 寄存器,而单线程的上限是 255。
以下是 wgmma 的几条使用规则:
Wgmma 已经解决了 scaling、CUDA core 与 Tensor Core 的 overlap、fp8 计算的支持问题,但仍然遗留下了两个问题:
针对这两个问题,Blackwell 又继续将 Tensor Core 和普通的 Thread 进行解耦。
Blackwell 引入了 Tensor Memory,即 TMEM,每个 SM 一块 256 KB 的 tensor memory,使用 32 位地址进行索引:高 16 位表示 lane,而低 16 位表示 column。按照 来组织,每格 32 bit,与整块寄存器堆同一个量级。
且不能够被 CUDA core 直接访问,必须使用 tcgen05.ld/st/cp;warp i 只能访问 lane 32 i ~ 32 i + 31,读取整个累加器需要 warpgroup 四个 warp 协作;分配的粒度是列,分配一列即分配 128 个 lane。
对于 m128n256 的累加器,刚好为 ,恰好为半个 TMEM,剩下的半块可以用于放下另一组累加器,天然适合 double buffer,Tensor Core 不需要等待累加器数据迁移即可继续计算。
Blackwell 上新的 Tensor Core 指令也变成 tcgen05.mma,不再需要 .sync.aligned,即不再需要整个 Warpgroup 来发射,可以选出一个单独的 Thread:elect.sync 由它来负责发射 MMA。tcgen05 支持以下类型:
其中带 mx 前缀的类别,scale factor 由硬件读取并反量化,不需要 CUDA 进行参与。K 随着元素位宽的变化而变化,具体可见表格。tcgen05.mma 的其余操作数如下:
[taddr_d]:累加器是一个 TMEM 地址。a_desc/b_desc:B 一定来自 smem descriptor,A 可以来自 smem descriptor 或 TMEM。idesc:32 位 instruction descriptor,运行时确定。p(enable_input_d:谓词,决定累加还是重新进行 gemm。.ws(weight statitionary)变体,支持 M=32/64 和 B 的驻留复用。之前也提到,累加器不再占用寄存器,大致的数据通路变为:
Tensor Core 负责计算,TMEM 负责保存结果,等到需要进行收尾工作时,再由 tcgen05.ld 将数据从 TMEM 搬回 Register。
这里仍旧需要 .sync.aligned,真正将结果搬运回 Thread 的各个 Register 时,每个 Thread 都要拿到数据自己的那部分数据,因此 Warp 线程需要参与,TMEM 到 Register 的读取需要各线程重新协作。
说到线程协作,sm90 的 wgmma 可以使用 wait_group 等待线程完成,而 tcgen05.mma 使用的则是 mbarrier,其是 Shared Memory 中的一个 64-bit 对象,主要维护 phase 、arrival count 和 transaction count,当对应的条件满足之后,Barrier 的 Phase 将会进行翻转。
mbarrier 的作用并不是像 __syncthreads() 一样等待所有线程走到同一个位置,而是用于记录和通知异步任务的完成状态。tcgen05.mma 发射之后,Tensor Core 会在后台继续计算,发射指令的线程并不需要停下来等待。等这一批计算完成后,可以通过 tcgen05.commit 将完成事件关联到某个 mbarrier;负责消费结果的线程只需要等待该 mbarrier 的 phase 发生翻转,就可以知道这一轮异步计算已经完成,并开始从 TMEM 中读取累加结果。也就是说,mbarrier 相当于异步硬件与线程之间的一块“完成状态牌”:生产者负责发起任务并在完成时更新它,消费者则通过等待它来判断数据什么时候可以安全使用。
总而言之,tcgen05 的同步规则大致如下:
st.shared 写入的数据要让 tcgen05.mma 看到,需要 fence.proxy.async.shared::cta。tcgen05.fence::after_thread_sync:跨线程场景(线程 A 发 mma、B 组做 epilogue)下,在 __syncthreads()/mbarrier 建立顺序之后、执行自己的 tcgen 05 指令之前。tcgen05.st 方向相反,用法对称。tcgen05.cp 是 smem→TMEM 的异步拷贝,主要用途是将 scale factor 矩阵搬运进 TMEM。Tile 越大,计算强度越高,但是 Tile 越大,A/B 输入压力和 Shared Memory 容量压力也越大。Blackwell 因此还支持 cta_group::2,让两个 CTA 合作完成一条 MMA。假设两个 CTA 分别计算 C 中上下相邻的两个 Tile:
它们的 B 是一样的,如果独立计算,则 B 需要被搬运两遍,如果两个 CTA 合作,则 B 只需要被搬运一次,这样能够在更大的 Tile 下继续提高输入数据复用率。
即使每代的算力翻倍,目前也无法满足需求,要进一步减少显存与带宽的占用、提高计算强度,就需要进一步探索更低的位数。Hopper 是 NVIDIA 第一代支持 FP8 Tensor Core 计算的 GPU。
FP8 主要有两种格式:
8 bit 的空间对于训练而言实在过小,因此直接将一个训练中的 Tensor 强行转成 FP8 往往不行,需要使用 Scale Factor。最简单的方法就是整个 Tensor 共用一个 Scale:以 E4M3 为例,
量化的过程即:
反量化:
假设大部分的值都在 之间,突然出现一个类似 3000 的数字,使用 量化之后,原本 0.1、0.2、0.5 这样的值,就会被压缩到非常有限的 FP8 的几个格点附近,整个 Tensor 的精度都被浪费掉了。
因此一个很自然的改进是不能让整个 Tensor 共用一个 Scale,需要进行分块。但是 GEMM 的 Scale 不能随意分割,因为
假设:
如果 对每一个 都不同:
Scale 也无法提到求和外面,即硬件不能简单执行一个普通低精度的 GEMM,而后统一乘以 Scale,因此 Scale 通常要求在 Reduction 维 上保持一段范围内不变。
需要注意的是,即使输入已经量化好了,Hopper FP8 Tensor Core 的累加本身也存在精度损失。FP8 Tensor Core 在进行累加时,会按照最大指数对齐部分乘积的尾数,仅保留最高约 14 bit 参与加法。
标准的 FP32 尾数部分有 24 位,在较长的 K 维累计过程中,误差可能会逐渐变大。DeepGEMM 提供了一个名为 promotion 的处理方法,准备两个累加器:
Tensor Core 先在 Part 上进行一段累加,然后 CUDA Core 将数据从 part 搬运到 acc,做一次完整的 FP32 Promotion,再清空 Part 继续,这种做法保证了精度,也意味着 CUDA Core 需要继续参与。在 Tensor Core 越来越快而 CUDA Core FP32 吞吐增长没这么快时,Promotion 的成本会变得越来越明显。
从 Blackwell 开始,Block Scaling 进一步做到 Tensor Core 硬件中。Scale Factor 不再由 CUDA Core 来手工加载、反量化、相乘,其直接成为 MMA 的附加输入:
Scale Factor 被存入 TMEM,由 Tensor Core 自己读取和反量化。前面提到的 tcgen05.cp 此时在 Scale Factor 的搬运中又起到了相应的作用。
进一步降低位宽以后出现了 FP6、FP4。例如 E2M1 格式的 FP4 ,非负的格点仅有 0,0.5,1,1.5,2,3,4。单个 FP4 数已经几乎没有多少表达能力,位宽越低,对于 Scale Factor 的依赖越强。
存储量化和计算量化不一样,常见的 W4A16 量化算法并不表示 Tensor Core 真正在执行 INT4 x FP16,GPTQ、AWQ 这一类方法经常做的是存储量化,存储时采用 INT4 weights 存储,经过 Kernel 反量化为 BF16 精度的权重后再进入 Tensor Core 计算。存储量化主要是降低显存和搬运压力,而计算量化则要求 Tensor Core 的实际运算精度也一并降低。
mmaa0~a7gid = lane >> 2
tig = lane & 3row
colwgmma.mma_async.sync.aligned.m64n64k16.f32.f16.f16
{d0,d1,...,d31}, //D:64x64 f32 64*64/128=32个寄存器/线程
a_desc, //A:64x16 64-bit descriptor,指向smem
b_desc, //B:16x64
scale_d,//1->D=AxB+D; 0->D=AxB
1,1, // imm-scale-a / imm-scale-b:对A/B整体取正负
0,0; // imm-trans-a / imm-trans-b:读的时候能否转置LBO = Leading Dimension Byte Offset
SBO = Stride Dimension Byte Offsetbase address
swizzle mode
base offsetrow 0 → bank group 0
row 1 → bank group 1
row 2 → bank group 2
...C0 = A0 x B
C1 = A1 x Bmma # Matrix Multiply-Accumulate
.sync # 指令执行前隐含一次warp sync
.aligned # warp内32线程必须同时执行,否为未定义行为。这条指令由全warp协作完成
.m16n8k16 # A 是 mxk = 16x16,B 是 nxk = 8x16
.row.col # A 行主序、 B 列主序——本质上是让K维连续
.f32.f16.f16.f32 # D / A / B / C:操作数fp16, 累加精度为 fp32